Keda 101
說明 KEDA ScaledObject 與 HPA 的分工、scale to 0 的條件,並以 cron trigger 範例示範設定與暫停方式。
Basic Arch
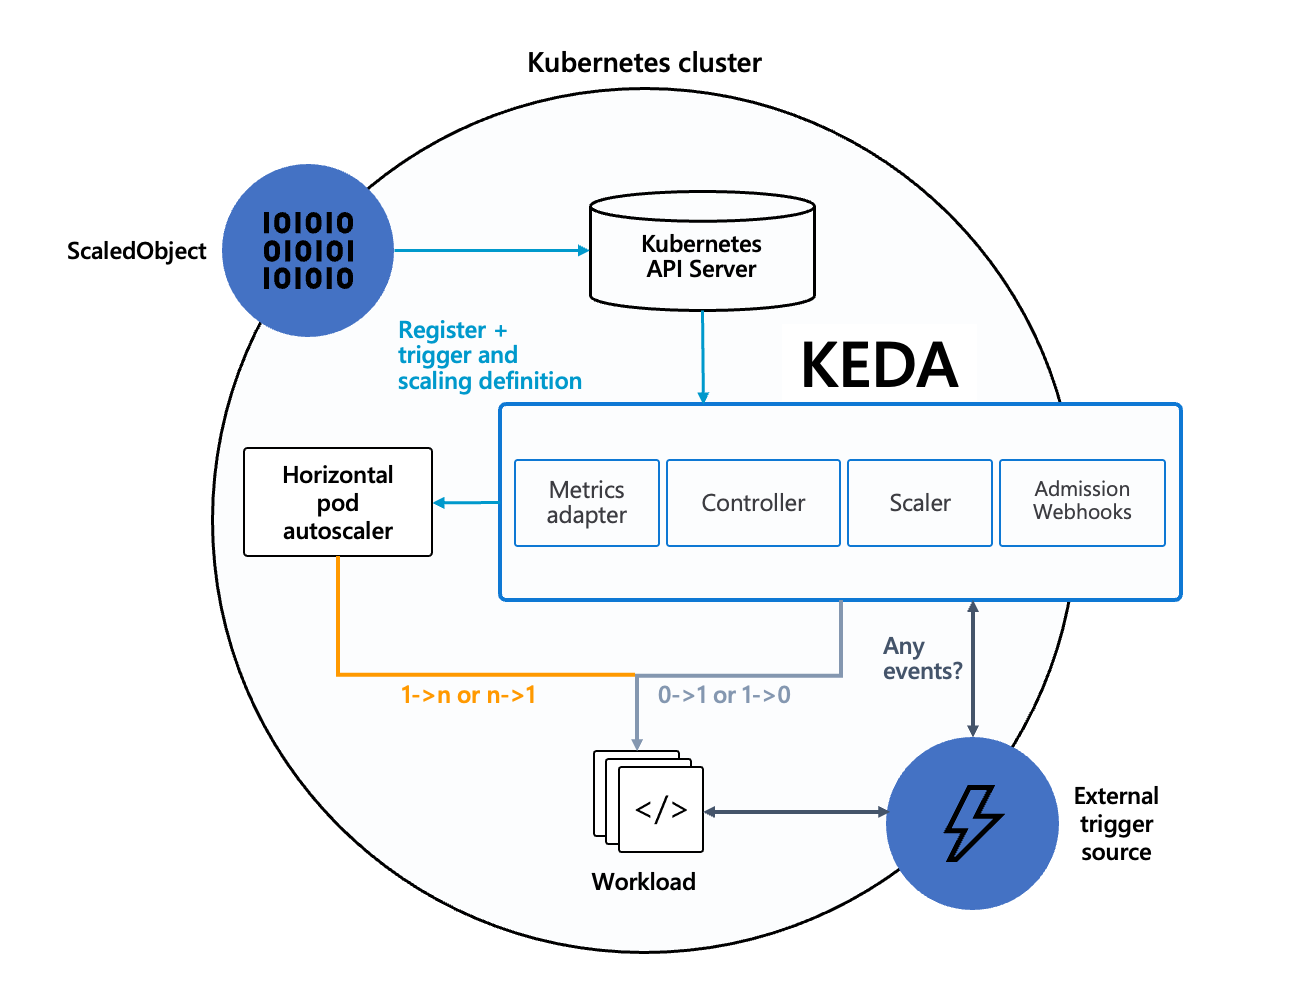
圖:KEDA 架構圖(來源:KEDA 官方文件,KEDA 專案文件採 Apache-2.0 授權)
核心概念:
-
ScaledObject 是 event 和 HPA 的介面,讓我們能透過 event 來去操控 HPA,達到 scaling 的效果
-
概念上分為兩個階段
- Activation Phase:由 Keda operator 負責 0 ↔ 1 scaling
- Scaling phase:由 HPA 負責 1 ↔ N scaling
會這樣切分是因為 HPA 本身不支援
minReplicaCount = 0- Keda 部分會取決於
IsActivefunction 的執行結果,來判斷現在是否要處理 0 ↔ 1 scaling - KEDA | Scaling Deployments, StatefulSets & Custom Resources
-
Applying Order:基於現狀選最大
- 在一個 ScaledObject 裡面,所有的 triggers 都會被轉成 HPA 的 metrics(ie, ScaledObject 裡面有五個 triggers,那他長出來的 HPA 就會有五個 metrics)
- HPA 會對每個指標各自算出期望副本數,最後取「最大值」作為本輪期望副本數;若有任一指標無法取到數值而其他指標建議縮容,會跳過縮容
- Horizontal Pod Autoscaling
其他補充概念:
-
Event 會可以從 workload、也可以從外部來(像是 SQS queue length)
-
Polling Interval
- Keda 在 Activation Phase 會根據 ScaledObject 裡面的 triggers 做 polling (間隔 based on
pollingInterval) - HPA 也會在 Scaling Phase 基於
kube-controller-manager的--horizontal-pod-autoscaler-sync-period來對 metrics 做 polling,預設是 15s
- Keda 在 Activation Phase 會根據 ScaledObject 裡面的 triggers 做 polling (間隔 based on
-
使用 Keda 要怎麼 scale 到 0?
根據第四點的邏輯,如果要 scale 到 0,必須要讓現狀滿足以下兩個條件
- 現狀不符合任何 trigger → 若現狀有符合任一個 trigger 條件,KEDA 會把目標 workload 的
replicas從 0 喚醒到 ≥1,然後交給 HPA 去處理 desired 數量 minReplicaCount或idleReplicaCount必須設置為 0
→ 接著 Keda 會 disable HPA,並且直接把 Deployment replica 設置為 0
→ 基本上寫 ScaledObject triggers 要以 scale up 的角度來寫,所有條件都不符合才會 scale down
- 現狀不符合任何 trigger → 若現狀有符合任一個 trigger 條件,KEDA 會把目標 workload 的
-
Difference between
minReplicaCount&idleReplicaCountminReplicaCount:在 Scaling Phase(有任何 trigger 被觸發時)最小的 replicaCountidleReplicaCount:在 Activation Phase(沒有觸發任何 trigger 時)時的 replicaCount- 現在這個值只能是 0,詳見 kedacore/keda
[Start: KEDA ScaledObject]
   │
   ▼
(1) KEDA 輪詢每個 trigger (pollingInterval)
   ├─ Trigger A → active 嗎?
   ├─ Trigger B → active 嗎?
   └─ Trigger C → active 嗎?
   │
   ▼
(2) 判斷「是否有任何一個 trigger active?」
   ├─ 是 → 進入「活動模式 Scaling Phase」
   │       │
   │       ├─ 如果目前 replicas = 0 → KEDA 直接把目標 workload 設成 ≥1
   │       └─ 將所有 triggers 轉換成 HPA 指標 (external metrics)
   │       └─ HPA 接管:
   │             ├─ 計算每個指標的期望 replicas,取最大值
   │             └─ 若計算結果 < minReplicaCount → 強制維持在 minReplicaCount
   │
   └─ 否 → 進入「非活動模式 Activation Phase」
   │       │
   │       └─ 有設定 idleReplicaCount ?
   │               ├─ 是 → replicas = idleReplicaCount
   │               └─ 否 → replicas = minReplicaCount
   │                         (如果 =0,就縮到 0)
   │
   ▼
(3) 重複下一輪 pollingInterval / HPA syncPeriod
Cron Trigger
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: gitlab-runner-arm-1
  namespace: gitlab-runner
spec:
  cooldownPeriod: 10
  idleReplicaCount: 0
  initialCooldownPeriod: 0
  maxReplicaCount: 4
  minReplicaCount: 0
  pollingInterval: 30
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: arm-gitlab-runner-gitlab-runner
  triggers:
    - type: cron
	    metadata:
        desiredReplicas: "1"  # 如果現況大於 1 且符合 trigger 條件,則不會改變數量
        end: 0 18 * * mon-fri
        start: 0 10 * * mon-fri
        timezone: Asia/Taipei
效果:週一到週五的 10:00 - 18:00,HPA 會確保我們的 replica ≥ 1。超過這些時間段以外,Keda 會確保我們的 replica = 0
但是他會直接去把 deployment replica count 改成 0,就算我們手動改成 1 還是會被 keda 改回去。解決方法為,暫時讓 keda 的 ScaledObject 停止作用,方法如下:
# ScaledObject 停止作用
kubectl annotate scaledobject gitlab-runner-arm-1 autoscaling.keda.sh/paused=true -n gitlab-runner --overwrite

# 加班完之後
# ScaledObject 開始作用
kubectl annotate scaledobject gitlab-runner-arm-1 autoscaling.keda.sh/paused=false -n gitlab-runner --overwrite